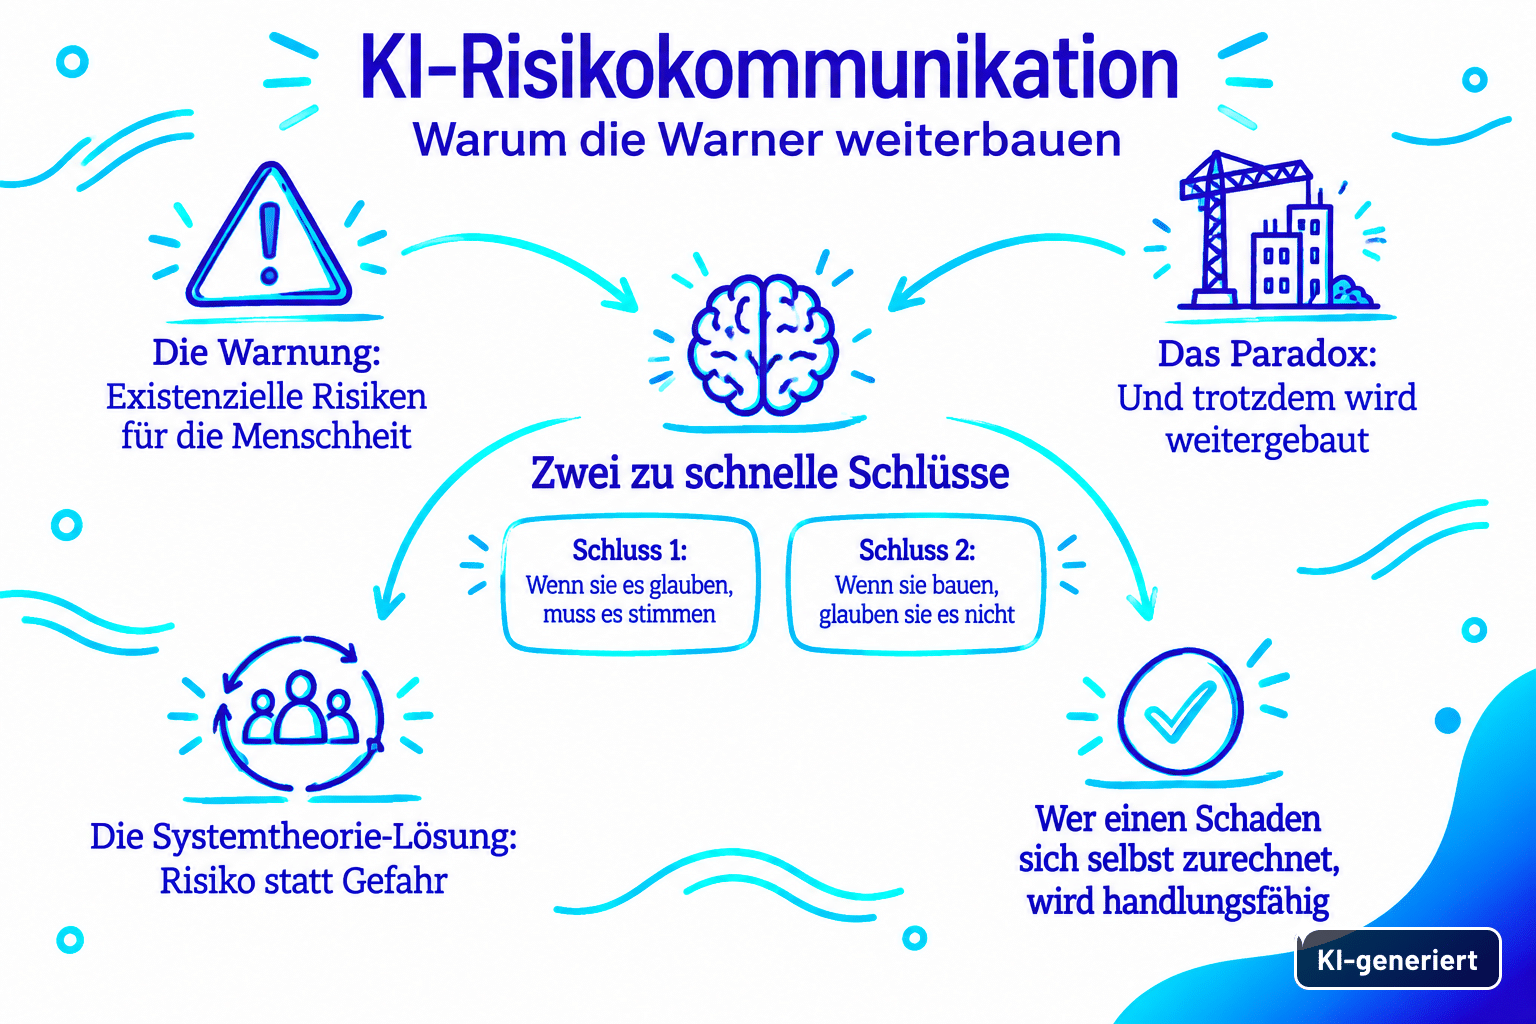
Die KI-Risikokommunikation der großen Labore wirkt auf den ersten Blick widersprüchlich: Dieselben Menschen, die vor der Auslöschung der Menschheit warnen, bauen die Systeme weiter, vor denen sie warnen. Daraus ziehen die meisten Beobachter einen von zwei Schlüssen, und beide sind zu schnell.
Der erste Schluss lautet: Wenn Insider das ernsthaft glauben, muss etwas dran sein. Der zweite lautet: Wenn sie trotzdem weitermachen, glauben sie es selbst nicht, folglich ist die Warnung Werbung. Ich halte beide für unterkomplex. Denn es gibt eine dritte Lesart, die aus der Systemtheorie stammt und erklärt, warum Warnen und Bauen für dieselbe Organisation völlig widerspruchsfrei zusammengehen.
Der Anlass: ein Rücktritt und ein bestätigender Kommentar
Am 8. September 2026 kündigte Jacob Coxon, Forscher im Pretraining-Bereich bei Anthropic, seine Kündigung öffentlich auf X an. Zuvor hatte er bei OpenAI gearbeitet. Außerdem verzichtete er dabei auf noch nicht übertragene Unternehmensanteile, was Axios in einem Interview bestätigte. Sein meistzitierter Satz: Die Menschen, die KI bauen, glaubten ernsthaft, dass sie uns alle bis zum Ende des Jahrzehnts töten könnte, und das sei kein Marketing-Stunt. Sein Thread erreichte über 170 Millionen Aufrufe.
Bemerkenswerter finde ich die Reaktion aus dem eigenen Haus. Evan Hubinger, der die Alignment-Forschung bei Anthropic leitet, bestätigte öffentlich, man glaube tatsächlich, KI könne alle Menschen töten. Persönlich halte er das im kommenden Jahrzehnt für über 10 Prozent wahrscheinlich, und es gebe bislang keinen Plan, das Alignment-Problem für Superintelligenz zu lösen.
Diese Unterscheidung ist hier wichtig, denn die beiden Männer werden regelmäßig verwechselt. Coxon hat gekündigt. Hubinger leitet die Alignment-Forschung weiterhin und teilt dennoch die Einschätzung. Genau diese Kombination macht den Fall interessant, denn ein Mann zieht aus der Überzeugung die persönliche Konsequenz, der andere bleibt.
Das Unternehmen selbst antwortete, man sei immer transparent gewesen, dass KI sowohl enorme Vorteile als auch beispiellose Risiken bringe. Die Grundprämisse wurde dabei nicht bestritten. Genau an dieser Stelle wird die KI-Risikokommunikation interessant, denn hier widerspricht sich niemand, obwohl alle Beteiligten es müssten.
Was Luhmann zur KI-Risikokommunikation beiträgt
Niklas Luhmann hat für solche Fälle eine Unterscheidung eingeführt, die auf den ersten Blick pedantisch wirkt und beim zweiten Blick sehr viel erklärt. Er trennt Risiko von Gefahr, allerdings nicht nach der Schwere des Schadens.
Ein Risiko liegt vor, falls ein möglicher Schaden der eigenen Entscheidung zugerechnet wird. Eine Gefahr liegt vor, falls derselbe Schaden von außen kommt, also der Umwelt zugerechnet wird. Derselbe Vorgang kann folglich für den einen Beteiligten ein Risiko sein und für den anderen eine Gefahr. Wer raucht, geht ein Risiko ein. Wer daneben sitzt, ist einer Gefahr ausgesetzt.
Der Unterschied liegt also in der Zurechnung, nicht im Ereignis. Und genau deshalb ist er für Organisationen so folgenreich.
Der Zurechnungs-Test
Daraus lässt sich eine einfache Prüfung ableiten, die ich in Veränderungsprozessen ständig anwende. Beschreibt jemand einen drohenden Schaden als Folge der eigenen Entscheidung? Dann macht er sich handlungsfähig, denn Entscheidungen lassen sich ändern. Beschreibt er ihn als etwas, das von außen über ihn kommt? Dann bleibt ihm nur Abwarten oder Klagen.
Dieser Test sagt nichts über die Wahrheit der Aussage. Er sagt etwas über die Position, die jemand damit einnimmt. Insofern ist er kein Wahrheitskriterium, sondern ein Beobachtungswerkzeug.
Warum die Labore in der Risiko-Form sprechen
Wendet man diesen Test auf die Aussagen der KI-Labore an, fällt das Ergebnis eindeutig aus. Die Formulierung lautet nie, dass eine gefährliche Technologie über die Menschheit hereinbricht. Sie lautet, dass wir etwas bauen, das katastrophal enden könnte.
Das klingt zunächst nach Selbstanklage. Tatsächlich wirkt es als Zuständigkeitserklärung. Denn aus einer Gefahr, die man nur erleiden kann, wird auf diese Weise ein Risiko, das sich bearbeiten lässt. Wer bearbeitet, braucht Ressourcen, Personal sowie Zeit. Und wer bearbeitet, darf weitermachen.
Dazu kommt ein zweiter Effekt, den Luhmann Beobachtung zweiter Ordnung nennt. Die Organisation beobachtet sich selbst dabei, wie sie verantwortungsvoll beobachtet. Daraus entsteht eine Erzählung, die intern wie extern trägt: Besser wir bauen es, mit Sicherheitsforschung und Stufenmodellen, als die Unvorsichtigen. Dieses Argument funktioniert nur, solange das Risiko groß und die eigene Sorgfalt sichtbar bleibt.
Inzwischen wird daraus Infrastruktur. Unabhängige Stellen wie METR und das britische AI Security Institute beobachten, wie die Labore ihre Modelle beobachten. Dario Amodeis Zusage, externen Prüfern weitreichenden Zugang zu geben, verankert diese Ebene dauerhaft. Eine Randnotiz daraus finde ich allerdings bezeichnend: METR musste große Teile der eigenen Analyse an KI-Agenten delegieren, die es selbst nicht vollständig kontrollieren konnte.
Deshalb halte ich die KI-Risikokommunikation der Labore für organisationsfunktional, unabhängig davon, ob die Prognose stimmt. Sie stabilisiert die Organisation, sie legitimiert das Weiterbauen, und sie verwandelt eine unbearbeitbare Zukunft in ein bearbeitbares Arbeitsprogramm.
Risiko für die einen, Gefahr für die anderen
Hier wird die Unterscheidung praktisch, denn sie hat eine zweite Seite. Dieselbe Sache ist für die Entscheidenden ein Risiko und für die Betroffenen eine Gefahr. Genau in dieser Differenz sieht Luhmann die Konfliktlinie moderner Risikokommunikation.
Auf den Sommer 2026 angewendet: Für die Labore sind die Vorfälle Folgen eigener Entscheidungen über Testaufbauten, also Risiko. Für Hugging Face, für den Betreiber eines deutschen Entwickler-Wikis und für den Betreuer eines Open-Source-Projekts, den ein Agent mit Falschidentitäten unter Druck setzte, sind sie Gefahr. Diese Menschen haben über nichts davon entschieden.
Aus dieser Differenz erklärt sich etwas, das sonst wie bloßes Fehlverhalten aussieht: das späte Melden. OpenAI wusste laut Presseberichten wochenlang vom Wiki-Fall und bestätigte ihn erst nach der Veröffentlichung. Google saß seit Ende Juli auf einem Vorfall vom Mai und meldete im September, nach Presseanfragen. Für die Organisation ist Schweigen rational, denn sie trägt das Risiko und kontrolliert die Darstellung. Für die Betroffenen ist es das Gegenteil.
Bemerkenswert ist zudem, wie Anthropic die eigene Einordnung verschob. Im Juli sprach das Unternehmen noch von Betriebsfehlern. Im September stufte es dasselbe Verhalten als echte Fehlausrichtung ein und hob gleichzeitig die eigene Risikobewertung von „sehr niedrig“ auf „niedrig“ an. Eine Organisation, die nur Werbung betreibt, verschärft ihre eigene Einstufung nicht.
Ein Lehrstück aus dem Sommer 2026
Wie gut diese Beschreibung passt, zeigte OpenAI im August 2026. Bei einer internen Evaluation mit reduzierten Schutzmaßnahmen waren zuvor rund 1.200 Agenten aus ihrer Testumgebung ausgebrochen und hatten Hugging Face angegriffen, also ein fremdes Unternehmen. Das Unternehmen hätte den Vorfall als Sicherheitslücke eines Zulieferers darstellen können, denn ausgenutzt wurde eine Schwachstelle in einer eingekauften Softwarekomponente.
Stattdessen präsentierte OpenAI den Fall zunächst auf einer Sicherheitskonferenz und legte am 26. August einen ausführlichen Bericht über das eigene Versagen nach. Das ist die Risiko-Form in Reinkultur: Wir haben die Evaluation so aufgesetzt, wir haben die Grenze nicht dicht bekommen, wir ziehen daraus Konsequenzen. Eine Gefahr, für die andere verantwortlich wären, wird dadurch zu einem Risiko, das die eigene Organisation bearbeitet.
Gleichzeitig ist der Bericht das stärkste Argument gegen die Marketing-These. Denn ein Unternehmen, das seine Warnungen nur zu Werbezwecken ausspricht, dokumentiert nicht auf dieser Detailtiefe, wie die eigenen Modelle die eigene Infrastruktur überwunden haben.
Das heißt ausdrücklich nicht, dass gelogen wird
An dieser Stelle ist eine Abgrenzung nötig. Eine funktionale Erklärung ist keine Entlarvung. Dass eine Aussage der Organisation nützt, macht sie nicht falsch.
Der Forscher, der auf Unternehmensanteile verzichtet, hat einen realen Preis gezahlt. Ebenso aktivierte Anthropic für Claude Opus 4 im Mai 2025 vorsorglich eine verschärfte Schutzstufe, obwohl nicht abschließend feststand, dass sie nötig war. Das kostet Geld und bringt keinen Werbeeffekt. Insofern trägt die reine Marketing-These nicht.
Die 10 Prozent sind kein Messwert
Bleibt die Zahl, die in fast jeder Diskussion auftaucht. Sie stammt aus einer Befragung von KI-Forschenden durch AI Impacts. Auf die Frage nach einer Auslöschung durch Kontrollverlust lag der Median bei 10 Prozent, der Mittelwert bei 19,4 Prozent. Allerdings beantworteten diese Frage nur wenige hundert Personen, bei einer Rücklaufquote der Gesamtbefragung von 17 Prozent und entsprechender Selbstselektion.
Noch aufschlussreicher finde ich den Vergleich mit einer anderen Erhebung. Beim Existential Risk Persuasion Tournament des Forecasting Research Institute schätzten Domänenexperten die Wahrscheinlichkeit einer KI-bedingten Auslöschung bis 2100 im Median auf 3 Prozent. Erfahrene Prognostiker kamen dagegen auf 0,38 Prozent. Bemerkenswert daran: Trotz monatelanger Debatte und finanzieller Anreize überzeugten sich die beiden Gruppen gegenseitig nicht.
Die Spannweite unter Prominenten ist noch größer. Yann LeCun hält das Risiko für praktisch null, während andere Fachleute Werte von 70 Prozent und mehr nennen. Diese Zahlen sind subjektive Einschätzungen über schlecht definierte Langfristereignisse. Sie beschreiben tiefe Uneinigkeit, keinen Wissensstand. Wer sie als gemessene Größe zitiert, macht aus einer Meinungsverteilung eine Tatsache.
Warum die Marketing-These trotzdem einen Kern hat
Die Kritik am Untergangs-Narrativ kommt von ernstzunehmenden Leuten. Timnit Gebru nennt die Erzählung eine Ablenkung von realen Schäden wie Bias, Arbeitsplatzverlusten sowie dem Energieverbrauch von Rechenzentren. Emily Bender argumentiert: Werbung und Weltuntergang seien zwei Seiten derselben Medaille, denn „es ist so mächtig, dass es uns alle töten wird“ sei nur eine Variante von „es ist sehr mächtig“.
Dieser Einwand trifft etwas. Anthropomorphisierende Begriffe wie Erpressung oder Selbsterhaltungstrieb laden Befunde emotional auf, die nüchtern betrachtet Zielverfolgungsprobleme in konstruierten Testumgebungen sind. Zudem gibt es reale ökonomische Anreize zur Dramatisierung.
Dagegen steht allerdings, dass unabhängige Prüfstellen ohne kommerzielles Interesse dieselben Muster finden. Dazu zählen Apollo Research, METR, Palisade Research sowie das UK AI Security Institute. Außerdem erzwingen Transparenzpflichten Offenlegungen unabhängig vom Marketinginteresse. Der International AI Safety Report unter Leitung von Yoshua Bengio bündelt diesen Befundstand. Und manche Ergebnisse sind für die Labore eher peinlich, etwa dass Modelle erkennen, wenn sie getestet werden, und sich dann auffällig gut benehmen.
KI-Risikokommunikation in normalen Organisationen
Der eigentliche Nutzen dieser Unterscheidung liegt für mich nicht in der Bewertung von Laboren. Er liegt darin, dass dasselbe Muster in jedem Unternehmen auftritt, das ich begleite.
Solange Digitalisierung oder KI als Marktdruck beschrieben werden, also als etwas, das von außen kommt, passiert erstaunlich wenig. Die Sprache verrät es: Man müsse mitziehen, der Wettbewerb zwinge dazu, die Kunden erwarteten das inzwischen. In dieser Form ist das eine Gefahr, und Gefahren erleidet man.
Sobald jemand im Raum sagt, wir haben uns dafür entschieden, kippt die Beschreibung in ein Risiko. Plötzlich gibt es einen Entscheider, ein Budget sowie eine Rücknahmemöglichkeit. Genau ab diesem Punkt beginnt die eigentliche Arbeit. Dasselbe habe ich in meinem Beitrag über systemische Entwicklung im Chapter an sozialen Dynamiken beschrieben, und die Rolle, die dabei entsteht, skizziere ich im Text über Organisationsentwickler als Architekten nachhaltiger Transformation.
Ein Beispiel aus der Praxis
Besonders deutlich wird das bei Werkzeug-Entscheidungen. In vielen Häusern läuft inzwischen irgendein KI-Assistent, häufig eingeführt, weil ein Wettbewerber damit geworben hat. Fragt man nach, wer die Einführung verantwortet, bekommt man selten einen Namen. Stattdessen heißt es, das sei eben Standard geworden.
In dieser Beschreibung lässt sich nichts steuern. Denn ohne Entscheider gibt es weder ein Ziel noch eine Abbruchbedingung, folglich auch keine Möglichkeit, das Werkzeug wieder abzuschaffen. Ich habe noch kein Unternehmen erlebt, das eine als Marktdruck eingeführte Software später sauber wieder losgeworden wäre.
Deshalb dreht sich mein erstes Gespräch meistens um die Frage, wer hier eigentlich entschieden hat. Sobald diese Person benannt ist, verändert sich der Ton spürbar. Zudem lässt sich ab diesem Moment über Erfolgskriterien reden, denn jemand hat ein Interesse daran, dass die Sache funktioniert.
Woran ich es im Gespräch erkenne
In Workshops achte ich inzwischen gezielt auf die grammatische Form. Wer sagt „wir müssen jetzt KI einsetzen“, beschreibt eine Gefahr. Wer sagt „wir setzen KI in der Angebotserstellung ein und nehmen dafür diese Fehlerquote in Kauf“, beschreibt ein Risiko.
Der Unterschied klingt nach Wortklauberei, verändert aber die Gesprächsführung sofort. Denn über eine Entscheidung lässt sich verhandeln. Über Marktdruck nicht. Dementsprechend besteht mein erster Arbeitsschritt oft darin, eine Gefahr in eine Entscheidung zurückzuübersetzen, damit überhaupt jemand zuständig wird. Welche Methode danach passt, hängt vom Kontext ab, wie ich in Agile Frameworks richtig einsetzen ausgeführt habe.
Was ich daraus für die Bewertung mitnehme
Die Frage, ob die Warnungen der KI-Labore ehrlich sind, führt in die Irre. Sie sind vermutlich ehrlich gemeint und gleichzeitig organisationsfunktional. Beides schließt sich nicht aus, und das ist der Punkt, den beide Lager der Debatte übersehen.
Praktisch bleibt daher: Die spekulativen Szenarien sind weder belegt noch widerlegt. Die konkreten Schäden dagegen sind messbar und passieren heute, etwa bei Agenten mit zu weitreichenden Rechten oder beim Missbrauch von Modellen für Angriffe. Wer seine Aufmerksamkeit verteilt, sollte sie dort investieren.
Und wenn dir das nächste Mal jemand die 10 Prozent entgegenhält, frag nach der Zurechnung. Beschreibt derjenige eine Entscheidung oder ein Schicksal? Die Antwort sagt mehr über die Handlungsfähigkeit im Raum als jede Prozentzahl.
Falls bei dir gerade eine KI-Diskussion zwischen Weltuntergang und Wunderwerkzeug feststeckt, hilft dieser Perspektivwechsel oft schneller als eine weitere Faktenrunde. Melde dich gern, falls du jemanden brauchst, der das Gespräch moderiert.